Dacă te întrebi de ce nu apare conținutul site-ului JavaScript în Google, începe prin a verifica pagina așa cum o poate vedea Googlebot după randare, nu doar în browserul tău. Conținutul încărcat prin JavaScript poate fi descoperit și indexat, dar numai dacă pagina este accesibilă, codul se execută fără probleme, iar conținutul rezultat poate fi interpretat. Ghidul de mai jos te ajută să separi problema de randare de cea de indexare și să stabilești când este nevoie de ajutor tehnic.
- Verifică pagina randată, nu doar codul inițial.: Conținutul care apare după executarea JavaScript trebuie să fie prezent și inteligibil în versiunea randată a paginii.
- Asigură accesul la resurse.: Fișierele JavaScript, CSS și datele necesare afișării nu trebuie blocate accidental pentru crawler.
- Separă randarea de indexare.: O pagină poate fi randată corect, dar să nu fie indexată din alte motive, precum o directivă noindex sau probleme de canonicalizare.
- Folosește linkuri HTML accesibile.: Navigarea importantă trebuie să poată fi descoperită prin elemente de link cu adresă clară, nu doar prin acțiuni JavaScript.
- Testează modificările pe URL-uri concrete.: Compară pagina problematică înainte și după remediere și verifică separat paginile de produs, categorie sau serviciu.
De ce poate lipsi conținutul JavaScript din Google
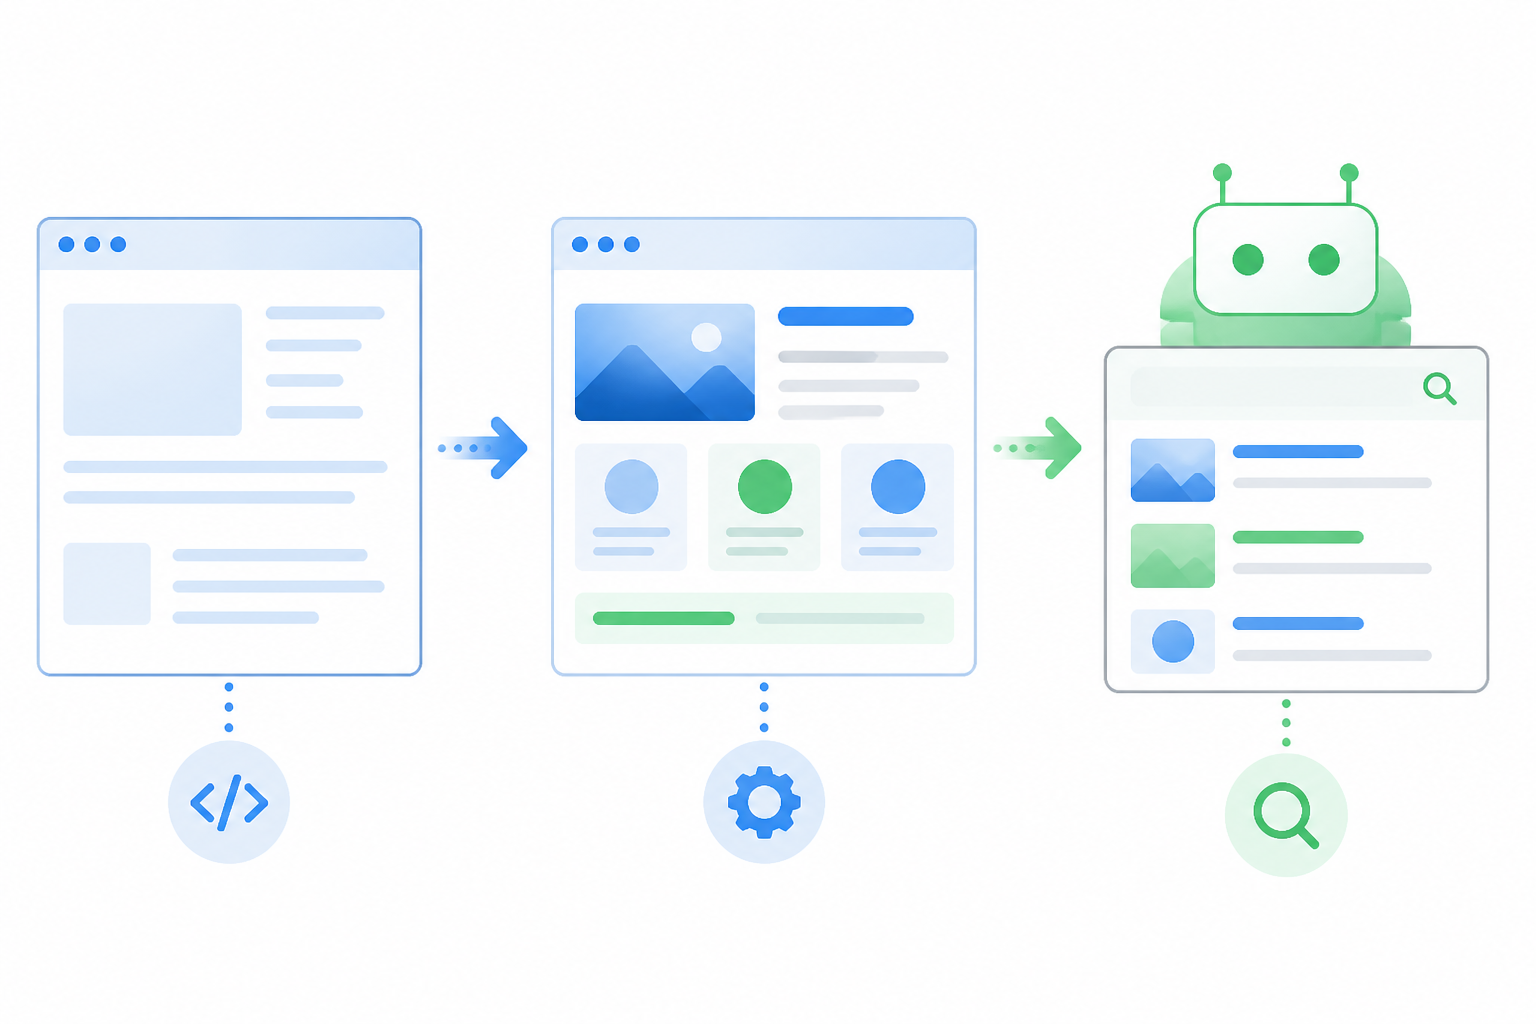
Randarea este o etapă distinctă de indexare.
Un site poate afișa în browser titluri, descrieri, produse sau articole încărcate dinamic. Asta nu înseamnă automat că Google vede aceeași pagină. Browserul poate executa codul fără erori evidente, în timp ce crawlerul întâmpină o resursă blocată, o cerere eșuată sau o componentă care nu se inițializează în condițiile sale.
Motoarele de căutare pot procesa JavaScript, însă procesul diferă de simpla citire a HTML-ului inițial. Dacă informația esențială apare numai după executarea unui script, trebuie să verifici dacă acel script poate fi preluat și dacă produce efectiv conținutul așteptat. Nici randarea corectă nu garantează indexarea: aceasta este o etapă distinctă, influențată și de acces, directive, canonical și calitatea sau utilitatea paginii.
Exemplu ipotetic: o pagină de categorie trimite inițial un container gol, iar lista de produse este cerută ulterior de la un API. Dacă cererea eșuează pentru crawler, pagina poate părea incompletă, deși pe laptopul proprietarului magazinului produsele se încarcă normal.
Cum deosebești sursa HTML de pagina randată
Sursa HTML inițială arată ce primește browserul înainte ca JavaScript-ul să modifice pagina. Versiunea randată arată rezultatul după execuția codului. Dacă un titlu important există doar în a doua, el depinde de randare și trebuie verificat în instrumentul de inspecție disponibil în Search Console sau într-un mediu de testare compatibil.
Nu trage concluzii doar din funcția „View Source” a browserului: aceasta nu este același lucru cu o inspecție completă a paginii randate. Caută în versiunea randată titlul, textul principal, linkurile relevante și metadatele pe care te aștepți să le găsească motorul de căutare.
- Alege un URL exact cu problema, nu doar pagina de pornire.
- Notează ce lipsește: text, produse, linkuri, titlu sau alt element.
- Repetă verificarea pentru mai multe tipuri de pagini dacă site-ul folosește șabloane diferite.
Conținut JavaScript în Google: verificări de bază
Începe cu o listă simplă, în ordinea în care depinde afișarea conținutului. Confirmă că URL-ul poate fi accesat fără autentificare, că nu este blocat prin robots.txt și că fișierele necesare randării pot fi încărcate. Apoi verifică dacă scripturile și cererile către API se finalizează cu succes.
În Search Console, folosește inspecția URL pentru a examina pagina și pentru a vedea dacă există probleme de accesare sau randare. Instrumentele pot arăta diferențe între pagina testată și ceea ce te așteptai să fie afișat. Disponibilitatea și detaliile afișate pot depinde de tipul verificării, așa că folosește rezultatul ca indiciu de diagnostic, nu ca explicație universală.
Deschide și consola de dezvoltare a browserului pentru URL-ul respectiv. Erorile JavaScript, cererile blocate, răspunsurile de server nereușite sau resursele care se încarcă doar după interacțiune pot indica locul unde se rupe procesul. Dacă problema apare doar pentru crawler, cere echipei tehnice să compare cererile și logurile relevante în condiții controlate.
Verifică dacă textul principal este disponibil fără interacțiune
Un vizitator poate apăsa un buton, accepta cookie-uri sau alege un filtru pentru a declanșa încărcarea. Googlebot nu trebuie să parcurgă un traseu de utilizare ca să afle ce reprezintă pagina. Titlul, descrierea principală și conținutul esențial ar trebui să fie disponibile în mod fiabil, fără să depindă de un clic, o trecere cu mouse-ul sau o sesiune personalizată.
Conținutul încărcat la derulare poate crea dificultăți dacă elementele importante apar numai după o interacțiune pe care crawlerul nu o efectuează. Pentru pagini cu listări lungi, asigură-te că produsele și legăturile către paginile lor pot fi descoperite prin navigare și paginare accesibile.
Controlează accesul la scripturi și date
Verifică regulile robots.txt, antetele de răspuns, permisiunile API și setările de securitate care ar putea împiedica încărcarea resurselor. O resursă blocată nu este neapărat singura cauză a unei pagini incomplete, dar poate împiedica randarea corectă.
Nu elimina reguli de securitate sau blocări pentru întregul site doar pentru a rezolva o singură pagină. Identifică exact resursa afectată și discută cu dezvoltatorul înainte de a schimba accesul.
- Compară textul vizibil cu cel din versiunea randată.
- Verifică solicitările către API și erorile JavaScript pe URL-ul testat.
- Confirmă că pagina importantă nu cere autentificare sau o acțiune pentru a încărca informația de bază.
Probleme de randare care apar frecvent
O cauză întâlnită este randarea care depinde de date externe. Dacă aplicația primește o eroare, răspunde cu întârziere sau cere o sesiune disponibilă numai utilizatorilor autentificați, componenta poate rămâne goală. Verifică dacă pagina păstrează un mesaj sau un conținut util atunci când datele nu se încarcă, fără a ascunde întregul subiect al paginii.
O altă cauză este codul care se execută doar după o acțiune. Butoanele de tip „încarcă mai mult”, filele interactive și filtrele pot fi utile vizitatorilor, dar nu ar trebui să fie singura cale prin care se pot descoperi conținutul important sau URL-urile produselor.
Mai pot apărea erori după actualizarea unei biblioteci, schimbarea unui endpoint, implementarea unui banner de consimțământ sau modificarea sistemului de rutare. Dacă problema a apărut după o lansare, compară modificările recente și testează șabloanele afectate înainte de a modifica toate paginile.
Oferă un răspuns HTML util
Pentru paginile importante, ia în calcul o redare pe server sau o generare statică, astfel încât conținutul principal să fie disponibil în HTML livrat inițial. Aceste abordări pot îmbunătăți robustețea, dar alegerea depinde de platformă, de cât de des se schimbă datele și de modul în care funcționează aplicația.
Randarea pe server nu repară automat toate problemele. Verifică în continuare codurile de răspuns, metadatele, linkurile, directivele de indexare și comportamentul după încărcare. Scopul este ca versiunea inițială să ofere informația esențială și ca experiența completă să rămână funcțională.
Evită conținutul diferit pentru crawler fără justificare
Nu configura o versiune specială care prezintă crawlerului informații diferite de cele oferite utilizatorului doar pentru a influența indexarea. Soluția sănătoasă este să faci conținutul important accesibil și coerent pentru ambele situații, cu diferențe explicabile prin funcționarea normală a site-ului.
- Testează paginile de produs și categorie separat, dacă folosesc componente diferite.
- Verifică efectul bannerelor de consimțământ asupra încărcării conținutului.
- După o remediere, confirmă că pagina oferă informații utile și când o cerere secundară eșuează.
Linkuri, navigare și adrese URL
Conținutul poate apărea în pagina randată, dar să rămână greu de descoperit dacă navigarea este construită numai din evenimente JavaScript. Folosește linkuri HTML cu o adresă de destinație explicită pentru categorii, produse, servicii și articole. Un element care doar execută o funcție la clic nu comunică la fel de clar o destinație.
Verifică dacă paginile importante au URL-uri distincte și stabile, dacă ruta se încarcă direct și dacă reîmprospătarea paginii nu produce o eroare. În aplicațiile cu rutare pe client, un traseu poate funcționa când ajungi la el din pagina de pornire, dar poate eșua când este accesat direct.
Pentru magazinele online, filtrele și variantele pot genera multe URL-uri. Decide care pagini reprezintă destinații utile și care combinații nu trebuie expuse ca pagini independente. O arhitectură neclară poate crea dubluri sau pagini slabe, chiar dacă JavaScript-ul funcționează corect.
Asigură navigarea către paginile importante
Creează legături crawlable între paginile relevante și nu te baza exclusiv pe căutare internă, filtre dinamice sau butoane care modifică starea aplicației. Sitemap-ul poate ajuta la descoperirea URL-urilor, dar nu înlocuiește o navigare coerentă în site și nu garantează indexarea.
Pentru magazinele cu filtre, consultă ghidul despre filtrele din magazinul online și paginile indexate de Google. Pentru relația dintre produse, variante și adrese, poate fi util și ghidul despre variante de produs și URL-uri în magazinul online.
- Testează fiecare URL important într-o fereastră nouă, nu doar navigând din pagina anterioară.
- Confirmă că linkurile folosesc destinații reale și stabile.
- Revizuiește separat paginile generate de filtre și parametri.
Cum afli dacă pagina este randată, dar neindexată
Dacă versiunea randată conține textul și linkurile așteptate, treci la verificările de indexare. Uită-te dacă pagina trimite o directivă noindex, dacă canonical indică o altă adresă și dacă URL-ul răspunde corect. Compară adresa testată cu URL-ul canonic pe care dorești să îl folosească site-ul.
Verifică și dacă pagina este suficient de distinctă și utilă față de alte pagini similare. Conținutul aproape duplicat, variantele cu parametri sau paginile goale pot ridica probleme care nu țin de JavaScript. Nu presupune că un rezultat de randare reușit înseamnă că URL-ul trebuie să apară în căutare.
În Search Console, urmărește raportarea asociată URL-ului și compară data ultimei accesări cu data modificării. Instrumentele de inspecție oferă informații despre starea cunoscută și despre testul curent, dar nu înlocuiesc analiza tehnică a site-ului. Dacă ai schimbat pagina, oferă crawlerului timp să o recrawleze; solicitările repetate nu repară o problemă de cod sau o directivă greșită.
Folosește un tabel de diagnostic
Notează pentru fiecare URL: codul de răspuns, starea de accesare, textul vizibil în pagina randată, erorile de resurse, directiva noindex, canonical și linkurile interne către pagină. Acest tabel face mai ușoară identificarea unui tipar, de exemplu dacă toate paginile unui anumit șablon au aceeași eroare.
Exemplu ipotetic: dacă toate paginile de produs au conținutul randat, dar indică prin canonical către aceeași pagină de categorie, cauza probabilă nu este încărcarea JavaScript, ci configurația canonical. Confirmă concluzia cu persoana care gestionează implementarea.
- Nu schimba canonical și noindex simultan fără să notezi starea inițială.
- Compară o pagină afectată cu una similară care funcționează.
- Documentează URL-ul, momentul testului și rezultatele înainte de a cere intervenție.
Plan de depanare pentru antreprenor și echipa tehnică
Pentru o verificare eficientă, lucrează în pași. Mai întâi selectează câteva URL-uri reprezentative și descrie exact ce nu se vede. Apoi verifică pagina randată și accesul la resurse. După aceea examinează erorile din browser, navigarea, codul de răspuns și directivele de indexare. Schimbă o singură componentă relevantă și testează din nou.
Dacă nu gestionezi codul, transmite dezvoltatorului dovezi concrete: URL-ul, conținutul așteptat, capturi sau detalii din inspecția URL, mesajele de eroare și momentul apariției. Menționează dacă problema afectează toate paginile sau numai un șablon. Cererea „SEO-ul nu merge” este mai greu de investigat decât „descrierea produsului lipsește din versiunea randată pentru aceste trei URL-uri”.
După remediere, testează un URL afectat și unul neafectat, verifică navigarea internă și confirmă că pagina rămâne funcțională pentru vizitatori. Apoi monitorizează starea URL-urilor în Search Console. Nu există un termen universal în care o schimbare va fi reflectată în rezultate, iar indexarea nu poate fi garantată printr-o singură solicitare.
Când este momentul să ceri ajutor tehnic
Implică un dezvoltator dacă problema pare să provină din aplicația JavaScript, API, rutare, configurarea serverului sau reguli de securitate. Cere ajutor SEO tehnic dacă randarea este corectă, dar există neclarități legate de canonical, noindex, pagini duplicate ori arhitectura URL-urilor.
Dacă modificarea implică reguli globale de robots.txt, infrastructură sau șabloane folosite de multe pagini, evită intervențiile improvizate. O modificare locală poate avea efecte neașteptate asupra altor pagini sau asupra experienței utilizatorilor.
- Păstrează un jurnal al modificărilor și al testelor.
- Cere ca dezvoltatorul să explice cauza, nu doar să aplice o soluție punctuală.
- Verifică atât comportamentul crawlerului, cât și experiența vizitatorului.
Întrebări frecvente
Google poate indexa un site construit cu JavaScript?
Da, Google poate procesa JavaScript, dar asta nu înseamnă că fiecare pagină sau element va fi automat randat și indexat. Scripturile trebuie să poată fi accesate și executate, iar pagina trebuie să respecte și celelalte condiții de accesare și indexare.
De ce văd conținutul în browser, dar nu în versiunea randată?
Browserul poate folosi o sesiune, o interacțiune sau o resursă care nu este disponibilă în testul crawlerului. Verifică erorile de script, cererile către API, autentificarea și dacă afișarea depinde de un clic sau de derulare.
Dacă pagina este randată, de ce nu apare în Google?
Randarea și indexarea sunt etape diferite. Verifică directivele noindex, canonical, codul de răspuns, accesul la pagină și eventualele probleme de duplicare sau utilitate a conținutului.
Este suficient să trimit URL-ul în Search Console?
Nu. Inspecția URL poate ajuta la diagnostic și poate permite solicitarea unei noi accesări, dar nu repară erorile de JavaScript, resursele blocate sau directivele greșite și nu garantează indexarea.
Trebuie să elimin JavaScript-ul de pe site?
Nu neapărat. În multe cazuri, este suficient să faci conținutul principal și linkurile accesibile în mod fiabil, să corectezi erorile de randare sau să folosești randare pe server ori generare statică pentru paginile importante.
Concluzie
Când conținutul unui site JavaScript nu apare în Google, identifică mai întâi etapa în care se pierde: accesarea, randarea sau indexarea. Verifică versiunea randată pentru URL-uri concrete, controlează resursele și linkurile, apoi examinează directivele și canonical-ul. O diagnosticare documentată ajută echipa tehnică să corecteze cauza reală fără schimbări ample și riscante.
Lecturi suplimentare
- Google Search Central: depanarea problemelor JavaScript pentru Căutare
- Google Search Central: introducere în Search Console
Ghiduri conexe
- Viteza site-ului și Core Web Vitals: ghid complet 2026
- Filtrele din magazinul online și paginile indexate de Google
- Cum compari datele din magazin cu Google Merchant Center
Hai să discutăm despre proiectul tău
Ai nevoie de un site de prezentare, de un magazin online sau de o colaborare pentru optimizare SEO și marketing digital? Echipa CreareSiteOnline.ro te poate ajuta să alegi serviciile potrivite obiectivelor afacerii tale, inclusiv SEO pentru magazine online.
contact@crearesiteonline.ro · 0731 935 067
București · Lucrăm cu afaceri din toată România.
Vezi serviciile de creare site și optimizare SEO · Contactează echipa